
AWS
마케팅 운영 Agent를 Amazon Bedrock AgentCore로 배포하기

2026.10.28
•
11 min read
AI의 기술이 성숙해지면서 다양한 곳에서 Agent의 활용 사례가 점점 많아지고 있습니다.
코멘토에서도 여러 업무에 AI를 적용하고 있고, 그중 하나가 마케팅 운영입니다.
이번 글에서는 로컬에서 실행하던 마케팅 운영 Agent를 Amazon Bedrock AgentCore로 배포하면서 고민했던 내용과, 실제로 막혔던 지점을 정리해보려고 합니다.
마케팅 운영 에이전트
코멘토 마케팅팀에서는 고객 아바타를 이해하고, 주간 성과를 진단하고, 광고 카피를 기획하는 일을 반복적으로 하고 있습니다. 이 일은 단순히 숫자를 보는 것만으로 끝나지 않습니다. 고객이 누구인지, 어떤 퍼널이 약한지, 어떤 소재가 잘 먹혔는지까지 이어서 봐야 합니다.
그래서 이 과정을 도와주는 마케팅 운영 에이전트를 만들었고 하나의 큰 Agent가 모든 일을 처리하기보다는, 역할을 나눈 여러 Agent가 순서대로 일하는 구조를 만들었습니다.
| 에이전트 | 하는 일 |
|---|---|
| 아바타 | 고객 데이터를 읽어 "지금 우리 고객은 누구인가"를 갱신 |
| 진단 | 주간 성과가 왜 이렇게 나왔는지 근본 원인 분석 |
| 카피 기획 | 아바타와 목표 퍼널에 맞는 광고 카피·앵글 기획 |
| 크리에이티브 분석 | 집행한 광고 소재의 승자/패자를 가려 운영 방향 추천 |
| 예산 | 다음 달 매체 믹스와 예산 배분 설계 |
| 성과 측정 | 새로 집행한 소재의 지표를 해석 |
Agent들을 만들 때 두 가지 원칙을 지키며 만들었습니다.
- 모든 것을 LLM에게 맡기지 않았습니다. YoY 매출 집계, 퍼널 전환율, 매체별 기여도 같은 정확한 숫자가 필요한 부분은 코드로 구현했습니다. LLM은 그 결과를 해석하는 역할만 맡게 했습니다.
- 입력된 숫자만 인용하게 했습니다. 마케터가 결과를 신뢰하려면 환각이 생기면 안 됩니다. 그래서 Agent는 실제로 존재하는 매체, 소재, 단계만 인용하도록 제한했습니다.
처음에는 이 시스템을 로컬에서 명령어로 실행했습니다. 하지만 운영 업무에 쓰려면 매번 사람이 실행하는 방식으로는 부족했습니다. 정해진 주기마다 실행되고, 결과가 저장되고, 한 명이 아닌 유관자가 보고 판단하기 위해서는 배포가 필요했습니다.
AgentCore 사용
이 시스템을 자동 운영하기 위해 Amazon Bedrock AgentCore를 사용하기로 했습니다.
Amazon Bedrock AgentCore란?
Bedrock AgentCore는 AI 에이전트를 배포·운영하기 위한 AWS의 매니지드 서비스입니다.
에이전트를 격리된 런타임(Runtime)에 올려 실행하고, 실행 간 컨텍스트를 저장하는 메모리(Memory),
외부 도구를 표준 방식으로 연결하는 게이트웨이(Gateway), 자격증명을 관리하는 아이덴티티(Identity) 등
에이전트 운영에 필요한 구성 요소를 제공합니다.
여기서 가장 메인으로 본 것은 Runtime입니다.
AgentCore Runtime은 Agent를 세션 단위로 격리된 microVM 위에서 실행하는 서비스입니다. 호출이 들어오면 해당 세션을 위한 격리된 실행 환경이 뜨고, 세션이 끝나면 환경이 정리됩니다. 저희는 Lambda에서 Runtime을 호출할 때마다 새로운 runtimeSessionId를 발급했기 때문에, 실행별 데이터가 섞이지 않는 구조를 만들 수 있었습니다.
이 구조가 주는 장점은 명확했습니다.
- 긴 실행 시간: Runtime 세션은 최대 8시간입니다. 저희 Agent의 LLM 호출은 보통 40~80초 정도 걸리고, 긴 추론은 더 걸릴 때도 있습니다. 이런 호출을 안정적으로 처리할 수 있는 실행 환경이 필요했습니다.
- 응답 스트리밍 지원: Runtime 응답은 chunk stream으로 받을 수 있습니다. 지금 구현은 토큰을 UI에 바로 흘리는 방식은 아니지만, 긴 실행이 끝날 때까지 연결을 유지하며 최종 JSON 응답을 받을 수 있었습니다.
- 세션 격리: 호출마다 새 세션을 만들면 깨끗한 환경에서 실행됩니다.
- 에이전트 단위 배포: Agent 하나가 곧 배포 단위가 되기 때문에, 역할이 다른 Agent를 독립적으로 올리고 갱신할 수 있습니다.
Lambda 활용 방법
처음부터 모든 것을 AgentCore Runtime에 넣으려던 것은 아니었습니다. 오히려 Lambda와 AgentCore Runtime의 역할을 분리하는 쪽이 더 자연스럽다고 판단했습니다.
- AgentCore Runtime: LLM 추론이 필요한 부분. 오래 걸리고, 매번 결과가 달라질 수 있는 비결정적 부분.
- Lambda: EventBridge 스케줄에 맞춰 실행되고, Agent들을 정해진 순서로 호출하고, 그 사이의 순수 계산과 결과 저장을 처리하는 결정적 부분.
이렇게 나누면 결정적인 흐름 제어는 Lambda가 맡고, 장시간 추론은 Runtime이 맡게 됩니다. 문제가 생겼을 때 어느 쪽을 봐야 하는지도 비교적 명확해집니다.
물론 Lambda가 하던 오케스트레이션과 계산까지 전부 AgentCore Runtime에 넣을 수도 있습니다. 하지만 짧고 결정적인 흐름 제어를 장시간 Agent 런타임 안에 넣는 것은 모양에 맞지 않다고 생각했습니다. 반대로 Agent 추론을 Lambda 안에 넣으면 15분 한도와 긴 대기 시간 문제를 계속 신경써야 했습니다.
그래서 라우팅, 재시도, 상태 관리 같은 조율은 Lambda에 두고, LLM 추론이 필요한 Agent만 Runtime에 올리는 방식을 사용했습니다.
배포 어댑터는 작게 유지
배포를 설계하며 정한 규칙도 있습니다.
배포 계층은 기존 로직을 감싸는 어댑터 역할만 하고, 실제 비즈니스 로직은 건드리지 않는다.
이미 로컬에서 개발을 했을 때부터 흐름을 조립하는 orchestrator, LLM을 한 번 호출하는 agent, 결정적 계산만 하는 service, 외부 I/O를 담당하는 adapter로 나누어져 있었습니다.
그래서 각 Agent마다 entrypoint 래퍼를 하나씩 두는 것으로 끝냈습니다. 아바타 Agent의 Runtime 래퍼는 아래 코드가 전부입니다:
app = BedrockAgentCoreApp()

@app.entrypoint
def invoke(payload: dict) -> dict:
    stats = AvatarStats.model_validate(payload["stats"])
    profile, latency_ms = run_avatar_agent(stats, display_name=payload["display_name"])
return {"profile": profile.model_dump(), "llm_latency_ms": latency_ms}run_avatar_agent는 로컬에서 쓰던 함수입니다. 래퍼가 하는 일은 payload를 검증하고, 기존 함수를 호출하고, 결과를 직렬화하는 것뿐입니다. Agent 로직을 고칠 때는 이 래퍼가 아니라 원래 함수를 고치면 되도록 했습니다.
실제 배포 구조는 아래와 같습니다. 전체 Agent 역할은 6개지만, 이번에 올린 것은 아바타, 진단, 크리에이티브 분석, 카피 기획 4개입니다.
- Runtime 4개: 아바타, 진단, 크리에이티브 분석, 카피 기획
- Lambda 2개: avatar_refresh_handler, weekly_loop_handler
- EventBridge: 격주/주간 트리거
Lambda 2개가 Runtime 4개를 나눠 호출합니다. 아바타 갱신은 격주로 따로 돌고, 주간 루프는 진단 → 크리에이티브 분석 → 카피 기획을 한 번에 이어 실행합니다.
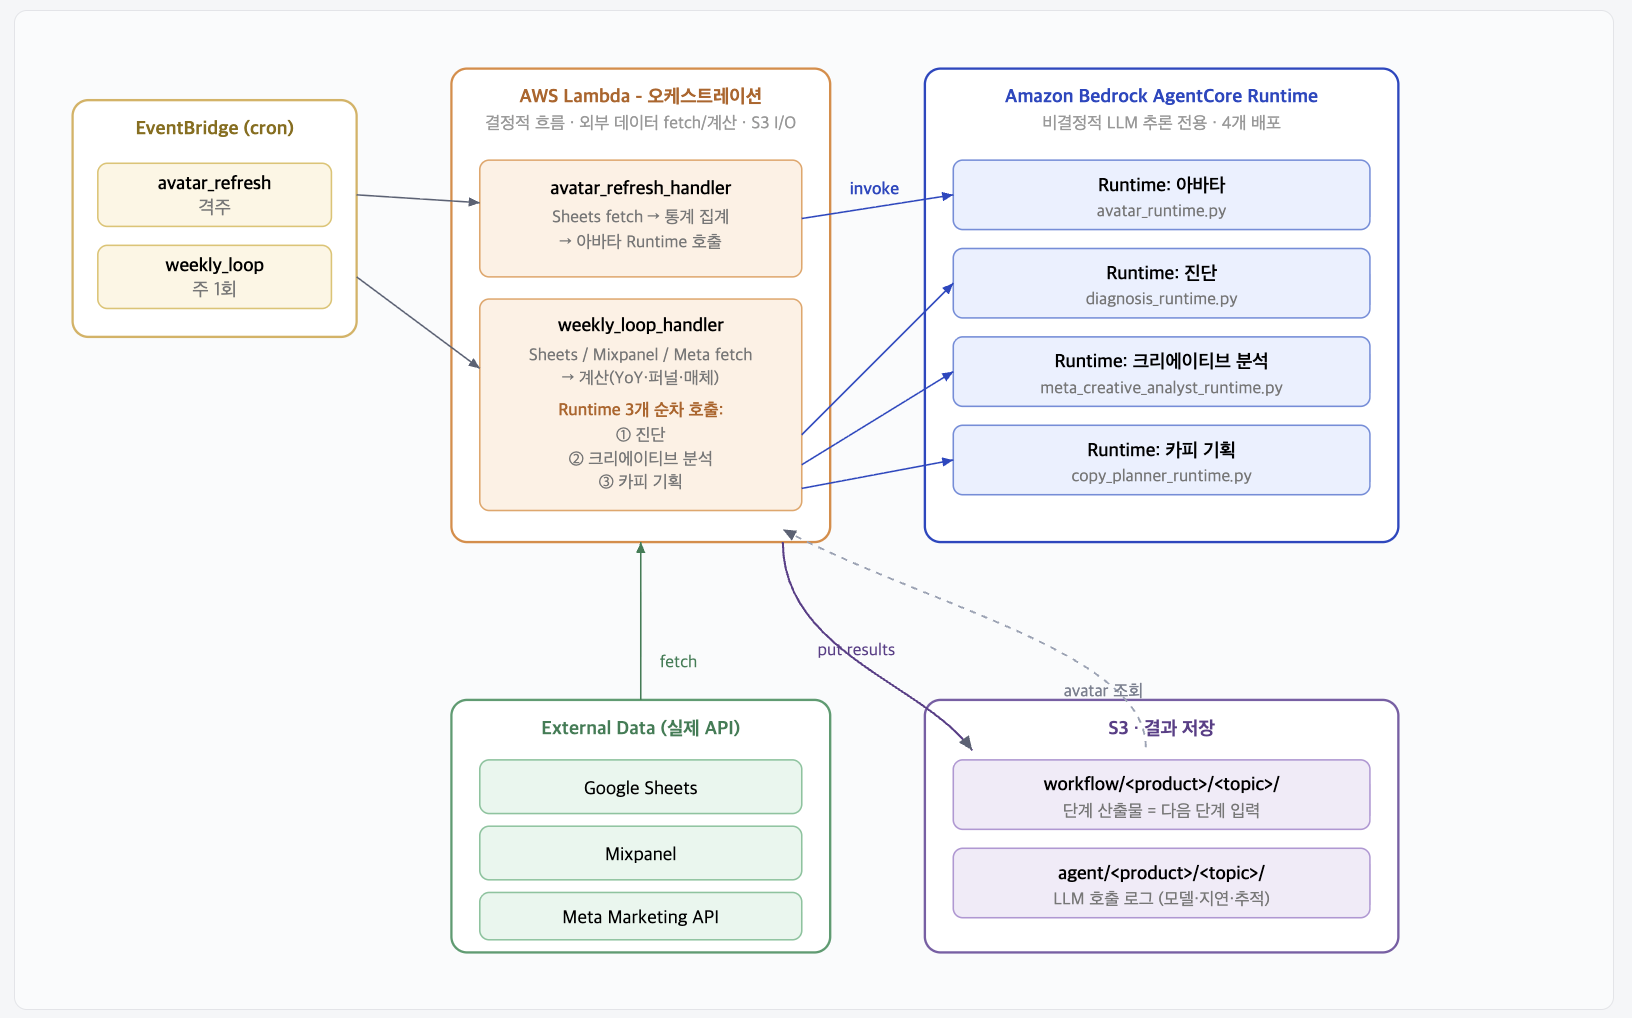
각 Runtime의 진입점은 위 래퍼 한 장이 전부고, Lambda는 그 Runtime들을 ARN으로 호출할 뿐입니다.
배포 후 생긴 이슈들
클라이언트 timeout을 직접 늘려야 합니다.
Runtime은 긴 실행을 버티지만, 호출하는 쪽의 기본 설정은 그렇지 않습니다. boto3(botocore)의 기본 read timeout은 60초입니다. 저희 Agent 호출은 보통 40~80초씩 걸렸기 때문에 응답을 받기도 전에 클라이언트가 끊기는 현상이 발생했습니다.
그래서 AgentCore Runtime을 호출하는 클라이언트에 timeout을 명시했습니다.
_AGENTCORE_CONFIG = Config(read_timeout=900, connect_timeout=60, retries={"max_attempts": 1})한글이 스트리밍 경계에서 깨집니다.
우리 구현에서 Runtime의 최종 JSON 응답은 chunk stream으로 전달되는데, 한글 같은 멀티바이트 문자가 chunk 경계에서 잘려 들어올 수 있습니다.
처음에는 chunk를 받자마자 디코딩했는데 이 경우에도 문제가 해결되지 않아서 bytes를 끝까지 모은 뒤 한 번에 디코딩 했습니다.
buf = bytearray()
for chunk in response.get("response", []):
    buf.extend(chunk if isinstance(chunk, bytes) else chunk.encode("utf-8"))
parsed = json.loads(bytes(buf).decode("utf-8"))
자격증명과 권한을 나눠서 잡아야 합니다.
Runtime에는 실행 IAM Role이 필요하고 Runtime을 호출하는 Lambda에는 bedrock-agentcore:InvokeAgentRuntime 권한이 필요합니다. 권한을 한 곳에 넣는 것이 아니라 Runtime과 Lambda의 역할에 맞게 나눠서 잡아야 합니다.
앞으로 진행할 것
AgentCore에는 Runtime 외에도 여러 기능이 있습니다. 다음 단계에서는 Memory, Gateway, Identity를 검토해볼 예정입니다.
- Memory: 실행 간 컨텍스트를 영속 저장하는 관리형 메모리입니다. 이전 실행 결과를 기억하면 주 단위, 월 단위 비교를 더 자연스럽게 만들 수 있을지 검토할 예정입니다.
- Gateway: 외부 데이터 소스를 MCP tool로 표준화해 Agent가 사용할 수 있게 하는 계층입니다. 지금은 Lambda에서 Google Sheets, Mixpanel, Meta 데이터를 가져와서 계산한 뒤 Agent에 넘기고 있습니다. Agent가 더 자율적으로 데이터를 다루는 구조가 좋을지 검토할 예정입니다.
- Identity: Runtime이 외부 자격증명을 관리형으로 주입받는 메커니즘입니다. 운영 주체가 늘어나고 자격증명 관리가 복잡해질 때 검토할 예정입니다.
마치며
로컬에서 돌아가던 Agent를 실제 운영 환경에 배포하려면 생각보다 고려할 것이 많았습니다. 실행 시간, 응답 처리, 세션 단위 격리, Agent 단위 배포 같은 것들이 그렇습니다.
AgentCore Runtime은 Agent를 운영하기 위한 실행 환경을 제공해주었고, Lambda와 역할을 나누니 오케스트레이션과 추론의 경계도 비교적 명확하게 가져갈 수 있었습니다.
물론 모든 문제가 자동으로 사라진 것은 아니었습니다. 호출 timeout, 응답 decode, IAM 권한처럼 직접 챙겨야 하는 부분도 분명히 있었습니다.
배포 어댑터를 작게 유지한 것도 도움이 됐습니다. 로컬에서 쓰던 핵심 로직은 그대로 두고, Runtime entrypoint는 payload 검증과 직렬화만 하게 했기 때문에 나중에 배포 전략을 바꾸더라도 핵심 코드는 그대로 둘 수 있습니다.
아직 더 해야 할 작업이 많이 있습니다. 그럼에도 이번에 시도했던 LLM Agent를 배포하는 경험이 운영하는 단계로 넘어가려는 분들에게 작은 참고가 되었으면 합니다.